傳統資安著重保護主機與網路,面對 AI 則必須多設一道「權限邊界」,否則 AI 就會越界。他為客戶規劃時的原則是依用途的風險決定邊界大小:風險越高,邊界越小、限制越多,因為一旦出事很難收拾;而產出危害較低的應用,則可適度放寬。
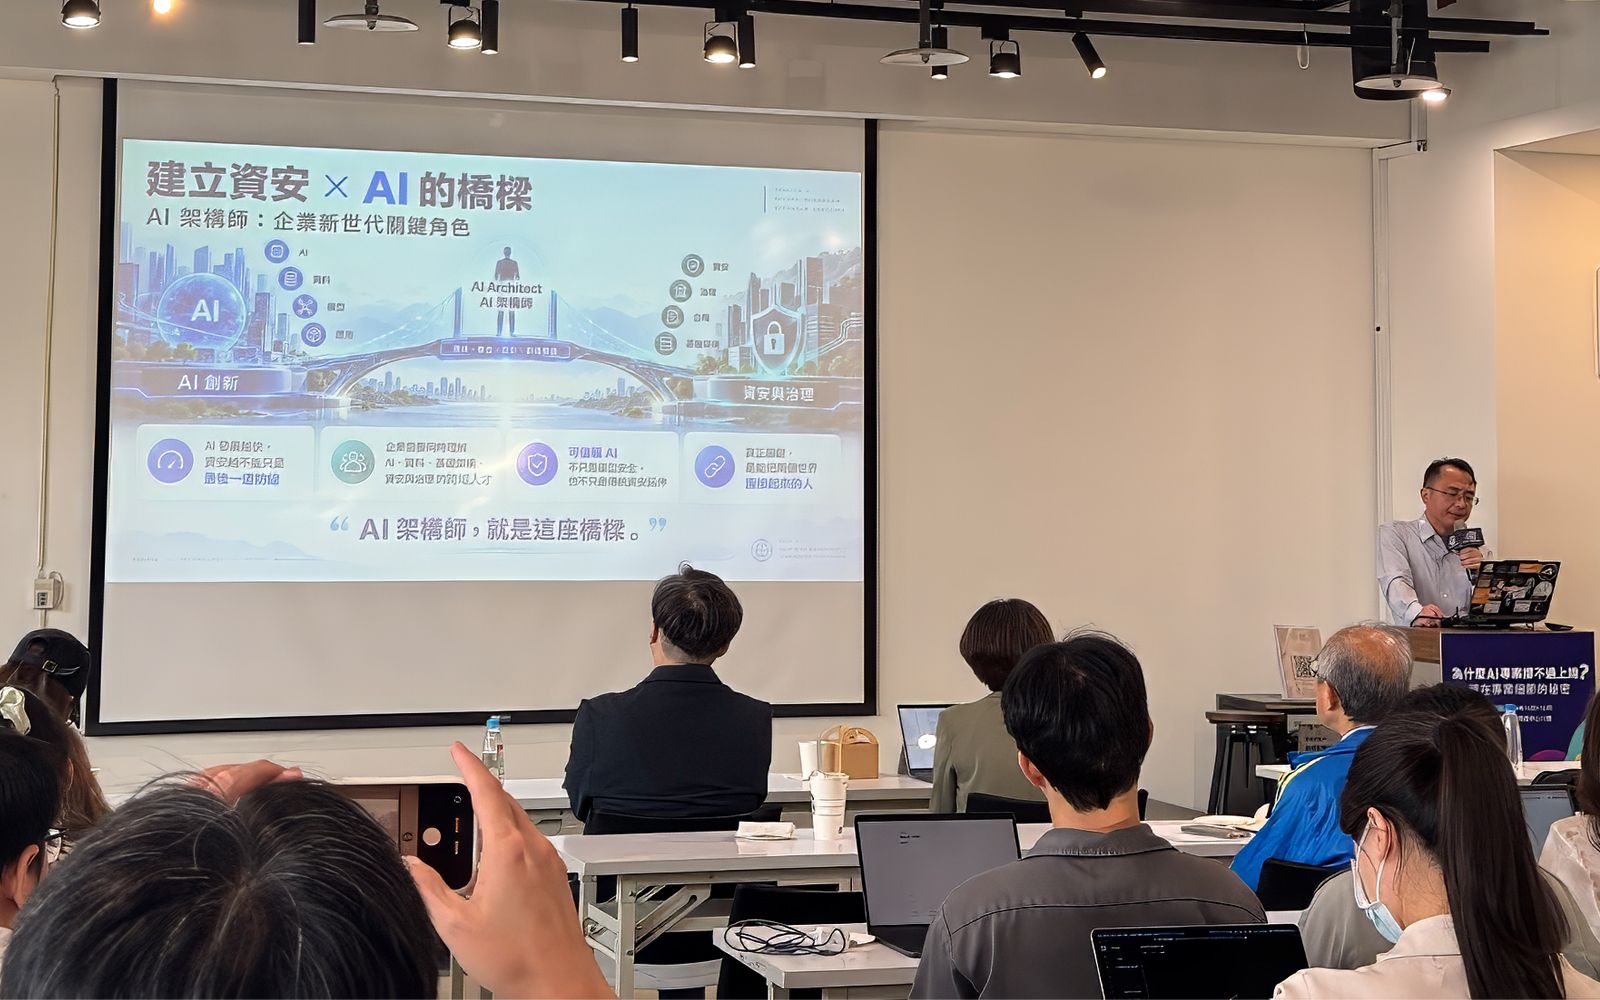
近幾個月來資安事件頻傳,多家 AI 程式開發與部署平臺接連出事,讓 AI 資安議題再度成為焦點。人工智慧科技基金會於 11 月 4 日舉辦 AI Cafe,以 AI 專案中的風險為切入點,邀請中華亞太智慧物聯發展協會理事長游文賢,分享 AI Agent 帶來的新型資安挑戰。
AI 從輔助走向自主,風險隨之擴大
游文賢指出,如果企業的AI導入只是在 ERP 等系統中加入 AI 功能,此時 AI 只扮演輔助角色,風險尚屬可控。真正的轉變在於,企業逐漸希望把整段工作交給 AI Agent 自主完成,風險也隨之擴大。
他進一步拆解 AI Agent 的運作要素。首先是「目標」,也就是要 AI 完成什麼任務。目標越單純,風險越低;若是讓 AI 執行轉帳這類任務,風險就相對高。其次是「感知」,AI 必須透過讀取文件等方式理解任務內容。第三是負責推理的模型,相當於 AI 的大腦,企業可以選用 Gemini 或其他模型,但模型內部如何運作,外界無從得知。第四是「規劃與工具呼叫」,由 AI 自行規劃執行步驟,並決定要呼叫哪些工具。他觀察,目前有意投入 AI Agent 的企業非常多,也積極將其與各種工具對接。第五是「執行與回饋」,讓 AI 實際完成任務,再將結果回饋檢視,但實務上,許多企業並沒有在導入時建立回饋機制。
最後一項是「自主性」,游文賢認為這是最棘手的一環。他以先前爆紅的開源 AI Agent「OpenClaw」(俗稱「龍蝦」)為例指出,這類工具推出時引發搶用熱潮,但它會自行運作、不受使用者干預,也不會主動回報執行結果。他表示,企業理應設計回饋機制,並安排人員審核 AI 的自主決策,但多數企業並未做到,因為大家都期待晚上讓 AI 自動執行,隔天一早就能完成工作。
駭客不必再硬闖,而是 AI Agent 主動開門
游文賢提醒,對 AI 而言,寫文章與寫程式是同一件事,因為程式碼也只是文字。若工具權限沒有管好,請 AI 寫一篇文章,它可能順手寫出程式碼並執行。攻擊模式也因此徹底改變:大企業的外圍防禦嚴密,駭客從外部硬闖不易,如今只要結合社交工程,誘使內部的 AI Agent 主動「開門」、把資料帶出去即可,事後還很難追查。他透露,這類事件每個月都持續發生,不少企業向他求助,處理起來卻相當棘手。
同樣的風險也出現在 AI 程式開發上。隨著企業從 Copilot 走向 AI Agent,研發等單位開始採用 Claude Code、Codex 等 AI coding 工具,把聊天式的 AI 體驗帶進企業內部。游文賢提醒,這類工具若能自動瀏覽網頁、存取系統,就必須先設好邊界。尤其近來爆紅的 Vibe Coding,雖然讓非工程背景的人也能開發小型應用,但程式寫得出來,使用者卻不見得知道其中有何風險,而這個「不知道」本身就是最大的風險。
游文賢指出,AI 風險與傳統資安最大的不同,在於會產生連鎖反應。過去系統出錯,問題只出在單一環節;如今 AI 與 AI 彼此串接,一處出錯便可能層層擴散,傷害範圍甚至很難在第一時間就完全掌握。
他進一步分析 AI Agent 帶來的幾項核心轉變。首先,資料外洩的源頭不同。過去企業擔心的是駭客竊取資料,如今卻是員工或 AI 主動把資料送出去。即使告訴 AI「這是機密」,它也沒有這個概念;人可以透過訓練建立警覺,AI 卻很難自行判斷。其次是合法權限遭到濫用。AI 使用的是正當帳號與權限,越權查詢在系統看來完全正常。第三是供應鏈汙染。許多業者讓 AI Agent 上網爬取資料,卻未經過濾便直接使用,其中是否夾帶惡意內容無從得知,這也正是難以根治的記憶汙染問題。最後,系統由層層串接而成,一旦出錯便難以追查;若設計時只求快、求省,沒有做好中斷機制,就容易引發連鎖反應。
每個 Agent 都要有身分,依風險劃定權限邊界
對此,游文賢建議企業為每個 AI Agent 設置身分 ID,並落實最小權限原則。就像每位員工都有各自的身分與權限,行政人員使用的 AI Agent,權限就不應超過行政人員本身。由於 AI 多透過 API 串接,傳統以密碼驗證身分的做法已不敷使用。目前已有資安廠商推出 AI Agent 身分認證服務,他強調關鍵在於及早導入,不要讓 AI Agent 擁有無限大的權限;像 OpenClaw 這類幾乎能存取一切的工具,就是很大的風險。
他指出,傳統資安著重保護主機與網路,面對 AI 則必須多設一道「權限邊界」,否則 AI 就會越界。他為客戶規劃時的原則是依用途的風險決定邊界大小:風險越高,邊界越小、限制越多,因為一旦出事很難收拾;而產出危害較低的應用,則可適度放寬。
在防護做法上,則有四項重點,一是處理好上下文(context);二是建立 API 白名單,由於 AI Agent 主要透過 API 運作,若不加以管控,API 就會成為攻擊入口;三是定期稽核,無論透過技術或人力,都要定時檢查 AI 的產出與對外傳送的資料,並檢視是否符合 ISO 42001 規範;四是中斷機制,AI Agent 一旦出事,至少要能「拔插頭」,而這最好在系統架構設計之初就要納入。
在治理層面,游文賢建議企業針對每一個 AI 應用訂定策略,包括判斷應用的風險高低、規劃生命週期管理,以及做好資料治理。人為監督同樣不可或缺,他認為,若企業導入 AI 後凡事都聽 AI 的,沒有人負責監督,就是很大的問題。
在生命週期管理上,他強調應從需求階段就開始檢驗:為什麼要用 AI、用什麼方法、手上有哪些資料。設計、開發、驗證各階段都要進行風險評估,即使設計與開發都沒問題,驗證未通過仍須退回重做。資安若不在探索階段就參與,後續將無法回溯。必須從第一階段開始,先釐清目的、資料與目標,再評估風險、擬定對策。
導入 AI 時要掌握的「三道防線」
游文賢建議企業導入 AI 時掌握「三道防線」。第一道是資料治理,資料是 AI 的原料,沒有做好資料治理,後續一切都無從談起;第二道是確立分析方法,並分階段推進;第三道則是建立人機協作,千萬不要期待 AI 能包辦所有工作,否則一旦出事,只會淪為人人都要背黑鍋。
在責任歸屬上,應由業務單位或專案經理(PM)掌握 AI 的作為並負最終責任,其他部門則扮演協助角色。他強調,分工方式沒有標準答案,重點是一定要有人負責;企業也不應把 AI 治理全部丟給資安部門,因為資安人員不熟悉業務,無法判斷 AI 的產出是否正確。
游文賢提出一份檢查清單,包括 AI 系統應建立在可信任的環境之上,做到可治理、安全、合規且可持續。其中,可稽核是合規的前提,系統若無法稽核,基本上就談不上合規。至於系統架構,最重要的是人的介入,每個關鍵環節都應有人確認,介入程度則視應用而定。
AI 資安與資料治理缺一不可
針對規模較大的企業,游文賢建議建立一套 AI 平臺,這指的不是自建大型模型,而是一套系統架構。他預期,未來兼具資安、AI 與系統架構知識,能整合企業業務、職能、技術與法規的「AI 架構師」需求將大增。這類人才培養不易,可從資安或數據背景的人才轉型培育。
游文賢認為,無論從 AI 或資安的角度,企業都必須建立信任、做好治理。他強調,AI 資安與資料治理是建立 AI Agent 架構的兩大基礎,缺一不可。